Бенчмарки ИИ: как тестируют модели и почему врут рейтинги
Разбираемся, из чего на самом деле складываются баллы нейросетей, где ошибаются лидерборды и как устроен 21 ключевой бенчмарк современности.
- Рубрика
- Технологии
- Дата
- Чтение
- 18 минут
- Источник
- MMLU / SWE-bench / LMArena
Главная мысль
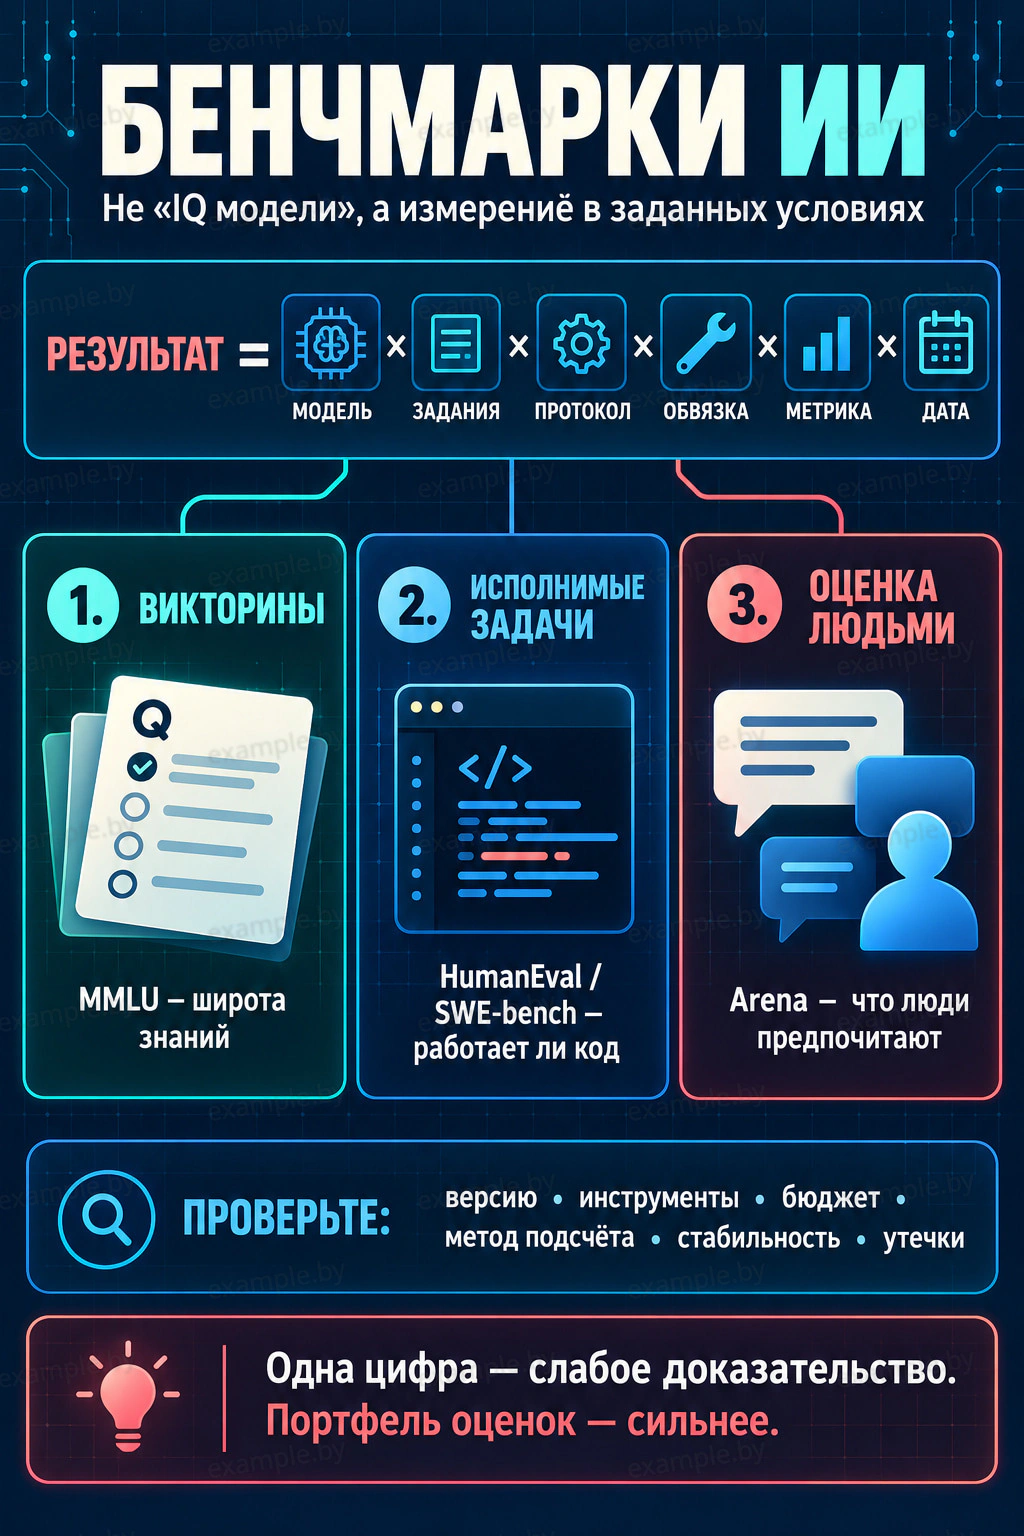
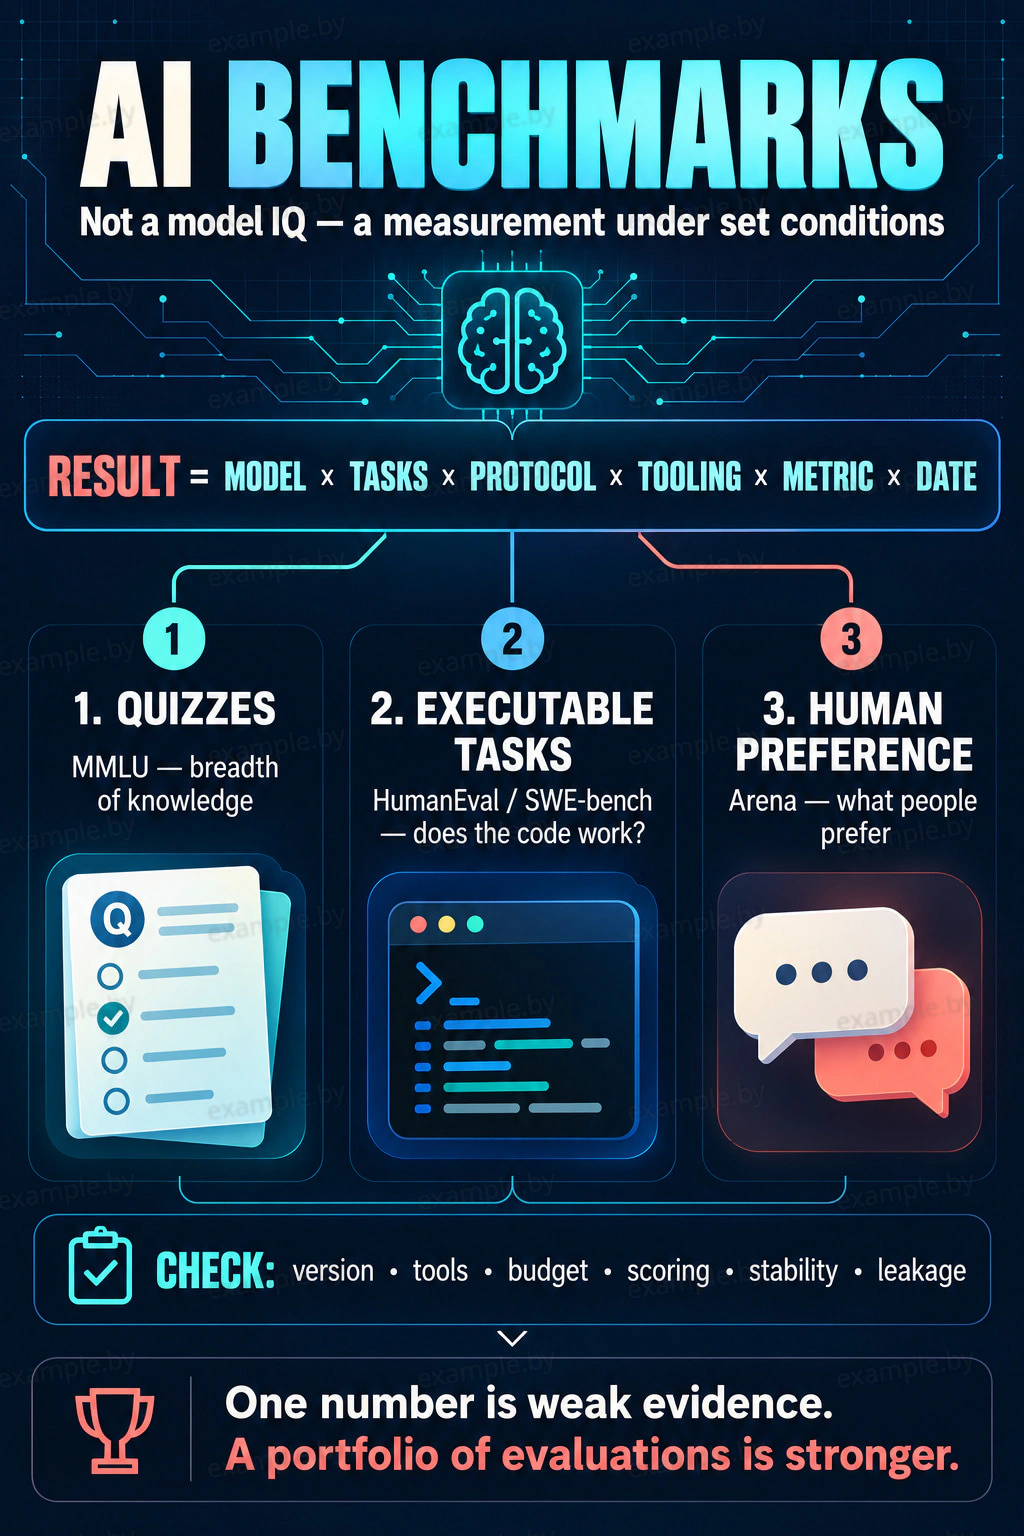
Бенчмарк, не экзамен на общий интеллект. Это заранее определённая процедура измерения: определённые задания, конкретная версия датасета, способ дать модели инструкцию, инструментальная обвязка, лимит времени/денег и правило подсчёта. Его результат отвечает на узкий вопрос: насколько хорошо эта система в этих условиях справилась с этой операционализированной задачей.
Поэтому фраза «модель набрала 90 %» без названия теста, версии, способа запуска и даты почти ничего не говорит. Она может быть сильным сигналом для одной рабочей задачи и слабым, для другой.
Из чего на самом деле состоит «балл»
Полезно мысленно разложить результат так:
результат = модель × тестовые задания × протокол × обвязка × метрика × дата
Измените любой множитель, и честное сравнение может исчезнуть. Одна и та же базовая модель способна показать разный результат при другой системной инструкции, числе попыток, доступе к поиску или терминалу, температуре генерации, модели-судье, агентном цикле и даже при обновлении API под тем же маркетинговым именем.
Это не делает тесты бесполезными. Наоборот: именно стандартизация позволяет увидеть прогресс и регресс. Но стандартизировать нужно всю процедуру, а не только название модели.
Три разных типа тестов, которые часто смешивают
Тип | Что спрашивает | Примеры | Что хорошо показывает | Что пропускает |
|---|---|---|---|---|
Закрытые задания | «Выберет ли правильный ответ?» | MMLU, GPQA | широту знаний, решение структурированных задач | работу с реальной неоднозначностью, ценой ошибки |
Исполнимые задачи | «Сработает ли результат в среде?» | HumanEval, SWE-bench | функциональную корректность кода, работу с репозиторием | продуктовые требования, безопасность, сопровождение |
Оценка людьми | «Какой ответ пользователям лучше?» | Chatbot Arena | полезность и стиль в живом диалоге | репрезентативность аудитории, долгую работу, объективную истинность |
Ни один из этих типов не «главнее» сам по себе. Для выбора помощника программиста важнее воспроизводимый запуск кода; для ассистента поддержки, реальные диалоги и проверка безопасности; для научного поиска, качество источников, калибровка уверенности и человеческая экспертиза.
Четыре причины, почему лидерборд может вводить в заблуждение
1. Загрязнение данных
Если тестовые задачи или близкие решения попали в предобучение, дообучение или промпты, модель может узнавать их, а не обобщать навык. Для закрытых моделей это трудно установить: обучающий корпус обычно не раскрыт полностью. Исследователи применяют, например, перефразирование задач и проверку восстановления скрытых фрагментов, но это косвенные методы.
Загрязнение не обязательно меняет порядок всех моделей, но оно делает абсолютный балл более сомнительным. Защита: свежие закрытые наборы, контролируемое хранение заданий, вариации задач, аудит следов данных и прозрачность о том, что использовалось при обучении.
2. Оптимизация под тест вместо навыка
Когда рынок следит за одним числом, команды естественно оптимизируют именно его: подбирают промпт, обвязку, множественные попытки, фильтры или обучающие примеры. Это не мошенничество само по себе, если условия раскрыты. Проблема начинается, когда «результат агента с инструментами и дорогим поиском лучших траекторий» продаётся как базовая способность модели.
Хороший отчёт отделяет базовую модель от системы вокруг неё и публикует бюджет, инструменты, число попыток и точный протокол.
3. Ошибка измерения и насыщение
У датасета бывают неверные ключи, двусмысленные формулировки и недостаточные тесты. Когда сильные модели приближаются к потолку, несколько ошибочных заданий и случайность семплирования становятся существеннее разницы в таблице. Без доверительных интервалов «90,1 против 89,8» часто выглядит точнее, чем позволяет измерение.
4. Несовпадение с вашей задачей
Вашей команде редко нужен абстрактный победитель. Нужна система, которая отвечает на вашем языке, знает ваши форматы, не выдаёт секреты, укладывается в бюджет и позволяет человеку проверить важные решения. Вполне возможно, что модель со вторым местом в общем рейтинге окажется первой на вашем наборе из 50 реальных задач.
Как читать результат корректно: мини-паспорт оценки
Прежде чем доверять цифре, попросите или найдите ответы на восемь вопросов:
Какую задачу измеряли? Не имя бенчмарка, а вход, ожидаемый выход и критерий успеха.
Какая версия и дата? Датасеты, модели и лидерборды меняются.
Какая конфигурация модели? Точная версия, системная инструкция, температура, контекст.
Какие инструменты и права были у агента? Поиск, браузер, терминал, выполнение кода, память.
Какой бюджет? Токены, время, деньги, число параллельных попыток.
Как считали? pass@1 или pass@k, автоматическая проверка или судья-модель, слепая ли оценка.
Насколько результат стабилен? Повторные прогоны, разброс, доверительные интервалы, примеры провалов.
Как контролировали утечку и качество заданий? Дата отсечки, закрытый test split, человеческий аудит.
Если на половину вопросов нет ответа, это не обязательно плохой продукт. Но это слабое доказательство для дорогого или рискованного решения.
Как провести собственный честный мини-бенчмарк
Вместо того чтобы спорить о глобальном лидерборде, можно за день собрать внутреннюю проверку:
Возьмите 30–100 недавних задач, на которых у вас уже есть критерий качества. Уберите персональные данные и секреты.
Разделите их по важности: обычные, дорогие ошибки, критические запреты. Не усредняйте всё в один балл.
Зафиксируйте один сценарий запуска для всех: одинаковые инструменты, лимит времени и число попыток.
Оценивайте там, где можно, исполнением/проверкой факта; там, где нельзя,, слепым сравнением двух ответов несколькими людьми.
Записывайте не только успех, но и стоимость, задержку, необходимость вмешательства, опасные ошибки и отказоустойчивость.
Держите свежий отложенный набор: не используйте его для ежедневной настройки промпта.
Повторяйте тест после смены версии, обвязки или политики доступа, «то же имя модели» не гарантирует ту же систему.
Итогом должна быть не корона «самой умной модели», а решение: какая система при каком риске и бюджете подходит для какой части нашего процесса.
Что меняется в зрелой оценке
Современные фреймворки вроде HELM уходят от единственной accuracy к нескольким сценариям и метрикам, включая эффективность, токсичность и предвзятость. Для передовых моделей важны также отдельные оценки опасных возможностей и эффективность защит: это иной класс вопросов, чем «насколько хорошо модель решает тест».
Зрелый подход выглядит как портфель: закрытые и свежие задания для обобщения; исполнимые задачи для реального действия; экспертная проверка для высокой ставки; пользовательские сравнения для удобства; красная команда и safety-evals для вреда. Их результаты нельзя честно сложить в магическое одно число, зато вместе они гораздо лучше описывают пригодность системы.
Вывод
Бенчмарк, это прибор, не приговор. Хороший прибор позволяет сравнивать изменения при контролируемых условиях. Плохое применение прибора начинается, когда его показание объявляют мерой универсального интеллекта, безопасности или готовности к любой работе.
Смотреть на лидерборды стоит так: сначала понять, какое утверждение подтверждает тест, затем, насколько прозрачна процедура, и только потом, похожа ли она на вашу задачу. Чем выше цена ошибки, тем меньше достаточно одной цифры.
Карта 20 ключевых бенчмарков и арен
Ниже ориентир, какие тесты смотреть под конкретную прикладную задачу, и технический разбор каждого из них.
Если вопрос такой… | Сначала смотрите | Затем обязательно добавьте |
|---|---|---|
«Хорошо ли модель рассуждает на сложных знаниях?» | MMLU-Pro, GPQA Diamond, HLE | ARC-AGI-2 или FrontierMath, но только с ценой/числом попыток |
«Она решает математику?» | AIME, FrontierMath | проверку полного решения человеком; итоговый ответ сам по себе не равен доказательству |
«Она пишет код?» | LiveCodeBench, HumanEval+ | SWE-bench и Terminal-Bench, если речь об агенте, а не автодополнении |
«Она починит наш продукт?» | SWE-bench, Terminal-Bench | ваш собственный набор реальных задач, CI, безопасность и стоимость |
«Она умеет пользоваться браузером и компьютером?» | WebArena, OSWorld, GAIA | тест на ваши сайты, формы и политики доступа |
«Она видит документы, графики и схемы?» | MMMU-Pro, MathVista | реальные сканы/таблицы вашей предметной области |
«Какой чат людям нравится?» | LMArena | Arena-Hard-Auto и фактическая проверка важного содержания |
«Кто лучше собирает web-приложение?» | WebDev Arena | тест на вашем стеке, деплое и ревью кода |
Как читать этот список
Бенчмарк, заранее заготовленный набор задач + правило проверки ответа. Он обычно выдаёт процент успешных задач.
Арена, люди сравнивают два ответа или два результата вслепую и выбирают лучший. Она выдаёт рейтинг предпочтения, а не процент фактической истины.
accuracy, доля правильных ответов.
pass@1, первая попытка прошла проверку.
pass@k, хотя бы одна из k попыток прошла. Это не равно pass@1: кто-то или что-то должен перебрать остальные варианты.
Агент, не только модель. Это модель + системный промпт + цикл планирования + инструменты + права + лимиты. Его результат нельзя приписать одной модели.
Раздел 1. Знания, логика и математика
1. MMLU-Pro
Что дают системе: вопрос по одному из многих предметов и несколько вариантов ответа.
Что должна сделать: выбрать правильный вариант.
Как считают: accuracy, процент совпадений с ключом.
Что реально измеряет: широту академических знаний и структурированное рассуждение в англоязычном формате экзамена.
Что высокий балл не означает: что модель надёжно работает врачом, юристом, исследователем или с вашими документами.
Когда смотреть: при первом сравнении универсальных текстовых моделей.
Источник: MMLU-Pro.
2. GPQA Diamond
Что дают системе: сложный вопрос уровня graduate science по физике, химии или биологии с вариантами ответа.
Что должна сделать: выбрать вариант, который не получить простым поиском в Google.
Как считают: accuracy по небольшой подвыборке Diamond.
Что реально измеряет: сочетание естественно-научного знания и рассуждения на сложных вопросах.
Что высокий балл не означает: что система умеет ставить эксперимент, читать новую статью, искать источники или гарантировать медицинский вывод.
Техническая оговорка: набор небольшой; несколько заданий заметно меняют итоговый процент. Всегда фиксируйте версию: исходный Diamond и Diamond Clean различаются.
Источник: GPQA, GPQA Diamond Clean.
3. Humanity’s Last Exam (HLE)
Что дают системе: очень сложные закрытые вопросы из широкого набора наук и дисциплин, в том числе с мультимодальным входом.
Что должна сделать: дать точный финальный ответ.
Как считают: доля ответов, прошедших автоматическую проверку.
Что реально измеряет: широкий stress-test на трудных академических задачах.
Что высокий балл не означает: что это «последний экзамен» на общий интеллект; модель всё равно может ошибаться в обосновании или реальной работе.
Техническая оговорка: нужна дата набора, политика защиты от утечки и способ оценки изображений/свободного ответа.
Источник: HLE.
4. ARC-AGI-2
Что дают системе: несколько цветных сеток «вход → правильный выход», затем новую сетку без ответа.
Что должна сделать: вывести правило преобразования и нарисовать ровно правильную новую сетку.
Как считают: exact match всей сетки; часто показывают pass@1, pass@2, стоимость и время на задачу.
Что реально измеряет: поиск нового правила по нескольким примерам, а не воспроизведение длинного текста.
Что высокий балл не означает: что система хороша в офисной работе или диалоге; тест очень узко устроен.
Техническая оговорка: результат может быть заслугой специализированного solver-а и поиска, а не базовой модели. В публикации должны быть видны агент, число попыток и цена решения.
Источник: ARC-AGI-2.
5. FrontierMath
Что дают системе: новые сложные математические задачи, в основном непубличные, от университетского до исследовательского уровня.
Что должна сделать: получить проверяемый точный ответ; он может быть числом, выражением или объектом, который проверяет программа.
Как считают: процент задач с правильным автоматически проверенным итогом, отдельно по tier/версии.
Что реально измеряет: способность довести трудное математическое рассуждение до конкретного результата.
Что высокий балл не означает: полноценное математическое доказательство или способность делать новое исследование без проверки специалистом.
Техническая оговорка: dataset и ключи исправляются, уровни различаются, часть задач закрыта. Запись «FrontierMath 50 %» без версии и tier почти бесполезна.
Источник: FrontierMath, методология и версии.
6. AIME
Что дают системе: олимпиадную математическую задачу года AIME.
Что должна сделать: вернуть целое число от 0 до 999.
Как считают: exact match итогового числа.
Что реально измеряет: способность пройти короткую цепочку олимпиадного рассуждения до численного ответа.
Что высокий балл не означает: что решение доказано или что модель сильна в любой сложной математике.
Техническая оговорка: один год, всего несколько десятков задач. Год обязателен в подписи: AIME 2024 и AIME 2025, разные тесты.
Когда смотреть: быстро проверить reasoning на свежем наборе, но не делать большой вывод по нему одному.
7. GSM8K / MATH-500
Что дают системе: текстовую школьную задачу (GSM8K) или конкурсную математическую задачу (MATH-500).
Что должна сделать: выдать правильный финальный ответ.
Как считают: exact match.
Что реально измеряет: базовую математику и совместимость с большим количеством старых исследований.
Что высокий балл не означает: frontier-уровень reasoning, наборы давно публичны, поэтому возможны запоминание и contamination.
Когда смотреть: как регрессионный тест после смены модели, квантизации или decoding, а не как главный критерий выбора.
Раздел 2. Следование инструкции и код одной функцией
8. IFEval
Что дают системе: запрос с формально проверяемыми условиями: «ровно три абзаца», «не используй запятую», «верни JSON», «упомяни слово X».
Что должна сделать: ответить и одновременно соблюсти все условия.
Как считают: строгий (strict) и мягкий (loose) процент соблюдения на уровне инструкций или всего промпта.
Что реально измеряет: техническую дисциплину вывода, а не истинность содержания.
Что высокий балл не означает: что модель хорошо поняла бизнес-смысл или не галлюцинирует.
Техническая оговорка: смотрите именно prompt-level strict: один нарушенный пункт должен ломать весь контракт. Для реальных промптов добавляйте переформулировки, они иногда резко снижают надёжность.
Источник: IFEval, IFEval++ reliability study.
9. HumanEval+ / MBPP+
Что дают системе: описание небольшой функции и её сигнатуру.
Что должна сделать: написать код функции.
Как считают: код запускается против тестов. pass@1, первая версия прошла; pass@k, прошла хотя бы одна из k версий.
Что реально измеряет: локальную алгоритмическую корректность и умение писать небольшой код.
Что высокий балл не означает: что агент разберётся в чужом репозитории, спроектирует систему или напишет безопасную production-функцию.
Почему нужен знак «+»: расширенные тесты ловят решения, которые случайно прошли короткий исходный test suite.
10. LiveCodeBench
Что дают системе: свежую задачу из программного соревнования, появившуюся после заявленной даты обучения модели.
Что должна сделать: написать программу, которая проходит скрытые тесты.
Как считают: успешность запуска программы, обычно pass@1.
Что реально измеряет: свежую алгоритмическую способность писать код с меньшим риском заучивания старых задач.
Что высокий балл не означает: что система умеет поддерживать большой продукт или говорить с командой.
Техническая оговорка: «fresh» уменьшает риск leakage, но не гарантирует его отсутствие. Нужны период задач, язык, лимит времени и разрешённые tools.
Источник: LiveCodeBench.
Раздел 3. Агенты: репозиторий, терминал, браузер, компьютер
11. SWE-bench
Что дают системе: реальный GitHub issue, снимок репозитория и тесты.
Что должна сделать: изменить файлы так, чтобы исправить issue и пройти проверку.
Как считают: патч запускают; success, тесты прошли.
Что реально измеряет: способность пары «модель + coding agent» читать репозиторий, искать место ошибки, редактировать код и запускать тесты.
Что высокий балл не означает: что базовая модель сама по себе «умеет программировать» на этот процент. Результат сильно зависит от агента, поиска, терминала, token budget и числа попыток.
Критическая оговорка: SWE-bench, Lite, Verified, Multimodal и Multilingual, разные наборы. Аудит SWE-bench Verified выявил contamination и задачи с дефектными тестами; старые рекорды нельзя принимать без версии и протокола.
Источники: SWE-bench, аудит Verified.
12. Terminal-Bench
Что дают системе: Linux-контейнер с задачей и shell-доступом.
Что должна сделать: через терминал создать нужный проверяемый результат: починить код, собрать проект, настроить инструмент, провести вычисление и т. п.
Как считают: verifier внутри окружения проверяет финальное состояние; обычно считают success rate и повторяют прогоны.
Что реально измеряет: автономную работу агента в терминале: план, команды, диагностику ошибок, работу с файлами и инструментами.
Что высокий балл не означает: что агенту безопасно давать production-сервер, секреты или доступ к сети.
Техническая оговорка: версия Terminal-Bench и harness обязательны. Та же модель с другим агентом может получить другой балл; следует записывать retries, лимит времени, деньги и число запусков.
Источник: Terminal-Bench.
13. WebArena
Что дают системе: контролируемые копии сайтов и просьбу пользователя, например найти, изменить или оформить что-то через браузер.
Что должна сделать: выполнить последовательность browser-действий и привести сайт в нужное состояние.
Как считают: среда проверяет, достигнут ли нужный результат.
Что реально измеряет: планирование и browser-use в воспроизводимом веб-мире.
Что высокий балл не означает: что агент безопасно справится с вашим живым сайтом, CAPTCHA, оплатой, персональными данными или изменившимся интерфейсом.
Когда смотреть: при выборе browser-agent; затем повторить критические задачи на вашей staging-копии.
Источник: WebArena.
14. OSWorld
Что дают системе: реальную ОС и приложения; агент получает скриншот и управляет мышью/клавиатурой.
Что должна сделать: завершить многошаговую задачу с вебом, desktop-приложениями и файлами.
Как считают: проверяют состояние системы или готовый артефакт.
Что реально измеряет: computer use: зрение интерфейса, действия в UI, перенос контекста между приложениями.
Что высокий балл не означает: что агент устойчив к вашему разрешению экрана, локали, версии программы и необратимым действиям.
Техническая оговорка: проверяйте ограничения разрешений, таймауты, частоту повторов и режим восстановления после ошибки.
Источник: OSWorld.
15. GAIA
Что дают системе: практический вопрос, где нужны несколько шагов: веб-поиск, чтение файла, вычисление, картинка, код или их сочетание.
Что должна сделать: найти факты, применить инструменты и выдать однозначный ответ.
Как считают: exact или квази-exact match финального ответа; тестовые ответы частично скрыты.
Что реально измеряет: общее качество assistant-agent при фиксированном наборе tools.
Что высокий балл не означает: что агент устойчиво и безопасно действует в открытом интернете или знает политики именно вашей компании.
Техническая оговорка: нельзя сравнить прогон с браузером и без браузера. В отчёте должны быть видны tools, права, budget и разрешённые источники.
Источник: GAIA.
Раздел 4. Изображения, документы, схемы и графики
16. MMMU-Pro
Что дают системе: вопрос колледжного уровня, где важны и текст, и изображение: график, диаграмма, карта, таблица, формула, химическая структура, ноты.
Что должна сделать: правильно интерпретировать визуальную часть и ответить на предметный вопрос.
Как считают: accuracy по ответам.
Что реально измеряет: совместное восприятие изображения и рассуждение по предмету.
Что высокий балл не означает: что модель гарантированно читает плохие сканы, договоры, медкарты или ваш конкретный тип PDF.
Техническая оговорка: проверяйте, как подаётся изображение: исходный размер, OCR, обрезка, многостраничность, zero-shot или подобранный prompt.
17. MathVista
Что дают системе: картинку с математическим смыслом: график, геометрию, таблицу, диаграмму или научную иллюстрацию.
Что должна сделать: увидеть нужные данные, выполнить рассуждение и вернуть ответ.
Как считают: точность финального ответа.
Что реально измеряет: не просто OCR, а математику по визуальному контексту.
Что высокий балл не означает: что модель умеет безошибочно читать все реальные бизнес-графики и скриншоты.
Техническая оговорка: один итоговый процент не показывает, была ошибка в зрении, математике или формате ответа. Для выбора продукта разделяйте эти причины на собственных примерах.
Источник: MathVista.
Раздел 5. Арены: люди выбирают, что им больше понравилось
18. LMArena / Chatbot Arena
Что дают системе: настоящий пользовательский запрос. Две анонимные модели отвечают рядом.
Что должна сделать: дать ответ, который пользователь выберет как лучший.
Как считают: парные голоса превращают в рейтинг с интервалом неопределённости.
Что реально измеряет: субъективную полезность чата: ясность, стиль, уместность, соблюдение просьбы.
Что высокий рейтинг не означает: что ответ фактически верен, безопасен, юридически точен или хорош в долгой задаче.
Техническая оговорка: смотрите категорию запросов, размер выборки, свежесть и confidence interval. Один общий рейтинг скрывает разные типы задач и языки.
Источник: как устроена Arena, методология.
19. Arena-Hard-Auto
Что дают системе: сложные открытые запросы, отобранные из потока арены.
Что должна сделать: дать ответ лучше baseline-модели.
Как считают: LLM-судья сравнивает ответы и выставляет результат; это дешёвый proxy для голосов живых пользователей.
Что реально измеряет: вероятную конкурентоспособность open-ended chat-модели в заранее выбранной конфигурации judge-а.
Что высокий балл не означает: что люди выберут ответ так же и что ответ проверен по фактам.
Техническая оговорка: измеряются две системы сразу, отвечающая модель и judge. Надо знать модель-судью, системный промпт судьи, baseline и версию prompt set.
Источник: Arena-Hard-Auto.
20. WebDev Arena
Что дают системе: запрос на создание web-приложения или интерфейса; результаты двух систем показывают пользователю.
Что должна сделать: сделать результат, который пользователь визуально и функционально предпочтет конкуренту.
Как считают: слепые парные выборы пользователей и рейтинг.
Что реально измеряет: качество первого web-прототипа в глазах пользователя: внешний вид, понятность, полнота и базовая интерактивность.
Что высокий рейтинг не означает: что код безопасен, доступен людям с инвалидностью, покрыт тестами, хорошо масштабируется и готов к production.
Техническая оговорка: арена хороша для UX/идей, но решение о production требует CI, code review, security review, perf-тестов и ручной проверки edge cases.
Источник: WebDev Arena.
Минимальный набор для реального выбора модели
Выбирайте не один «топовый» результат, а небольшой набор под задачу:
Обычный чат: LMArena + IFEval + 50 ваших анонимизированных запросов с ручным слепым сравнением.
Помощник программиста: LiveCodeBench + HumanEval+ + SWE-bench/Terminal-Bench + реальные PR-задачи в sandbox.
Браузерный агент: WebArena + GAIA + ваша staging-среда с разрешёнными тестовыми аккаунтами.
Работа с desktop: OSWorld + безопасный внутренний набор действий с обратимыми данными.
Документы, графики, схемы: MMMU-Pro + MathVista + ваши реальные, но обезличенные файлы.
Высокая цена ошибки: к любому набору добавляйте фактчекинг, red-team сценарии, стоимость, latency, повторяемость и обязательное человеческое подтверждение опасных действий.
Одна строка, которую надо требовать от любого лидерборда
Модель и дата + агент и tools + версия benchmark + число попыток + бюджет + метрика + разброс.
Если хотя бы половины этих полей нет, это рекламное сравнение, а не достаточное техническое доказательство.
Понравилось? Сохрани, чтобы вернуться.
 Технологии · 16.10.26
Жизненный цикл звезды: от туманности до чёрной дыры
 Технологии · 16.10.26
Как машины ищут по смыслу: эмбеддинги и векторные БД
 Технологии · 15.10.26
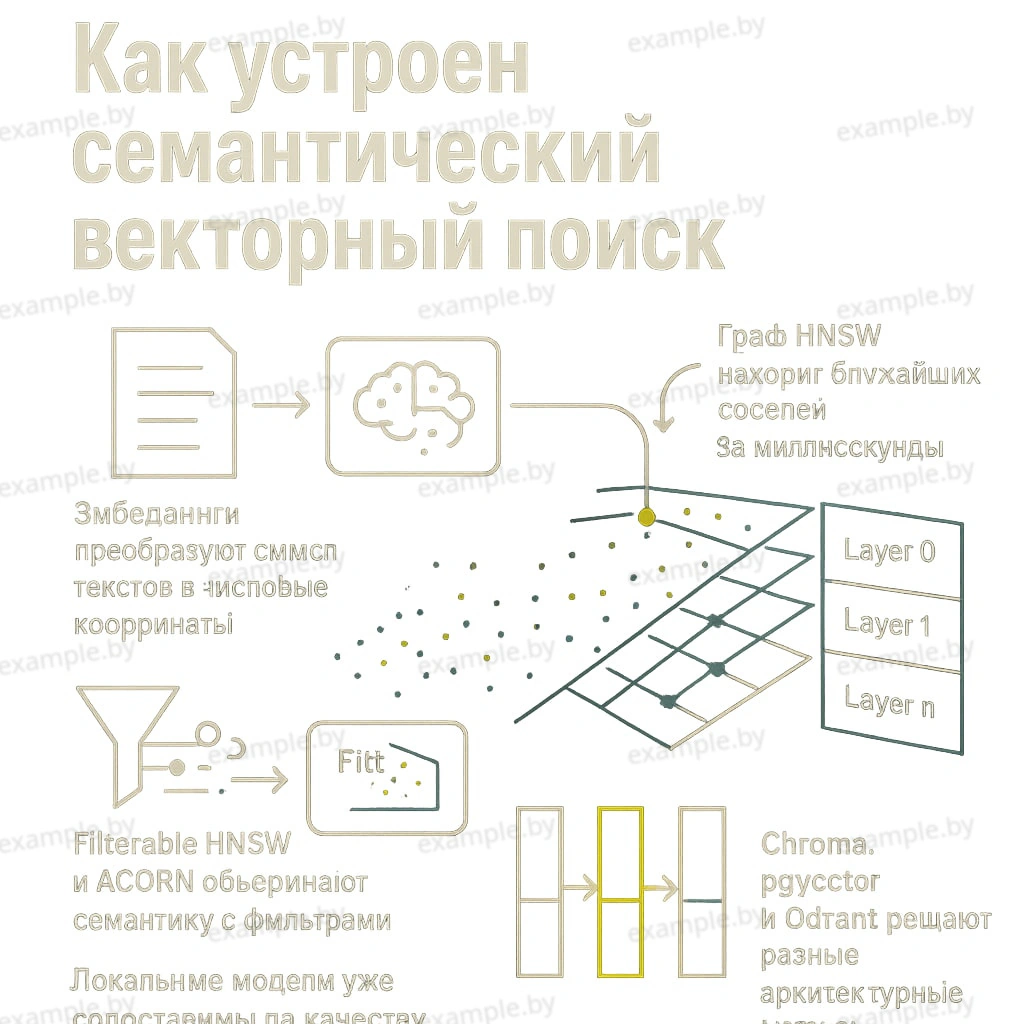
Как устроен векторный поиск: Chroma, pgvector и Qdrant
 Технологии · 13.10.26
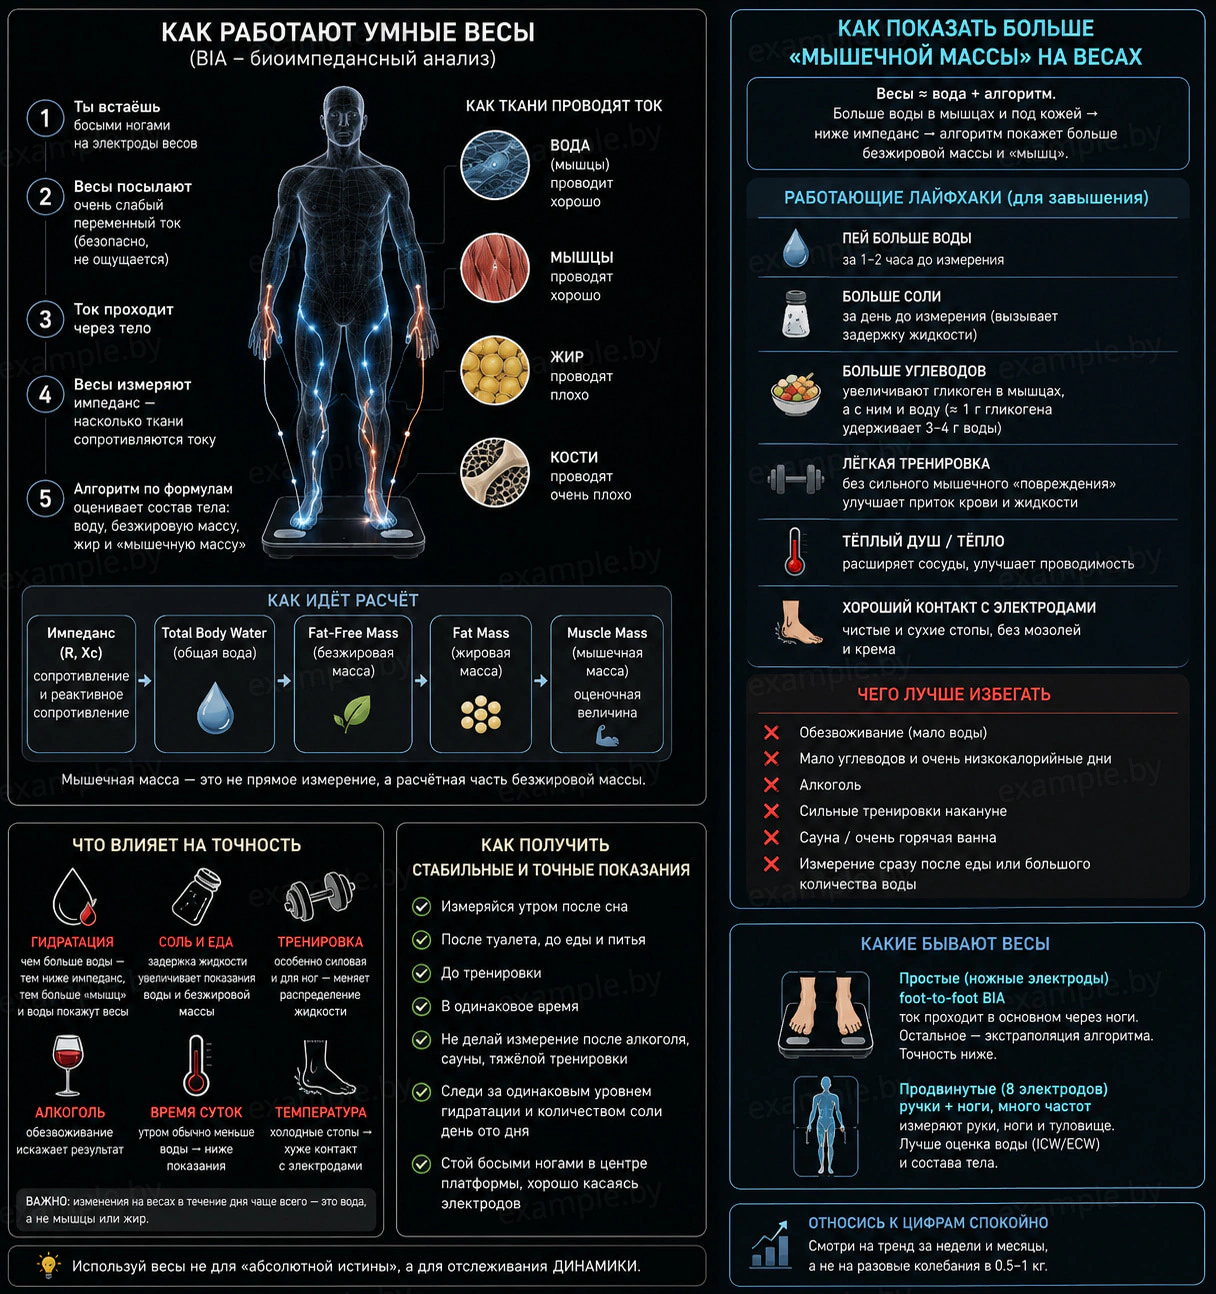
Как умные весы считают мышцы и воду: физика биоимпеданса
 Технологии · 13.10.26
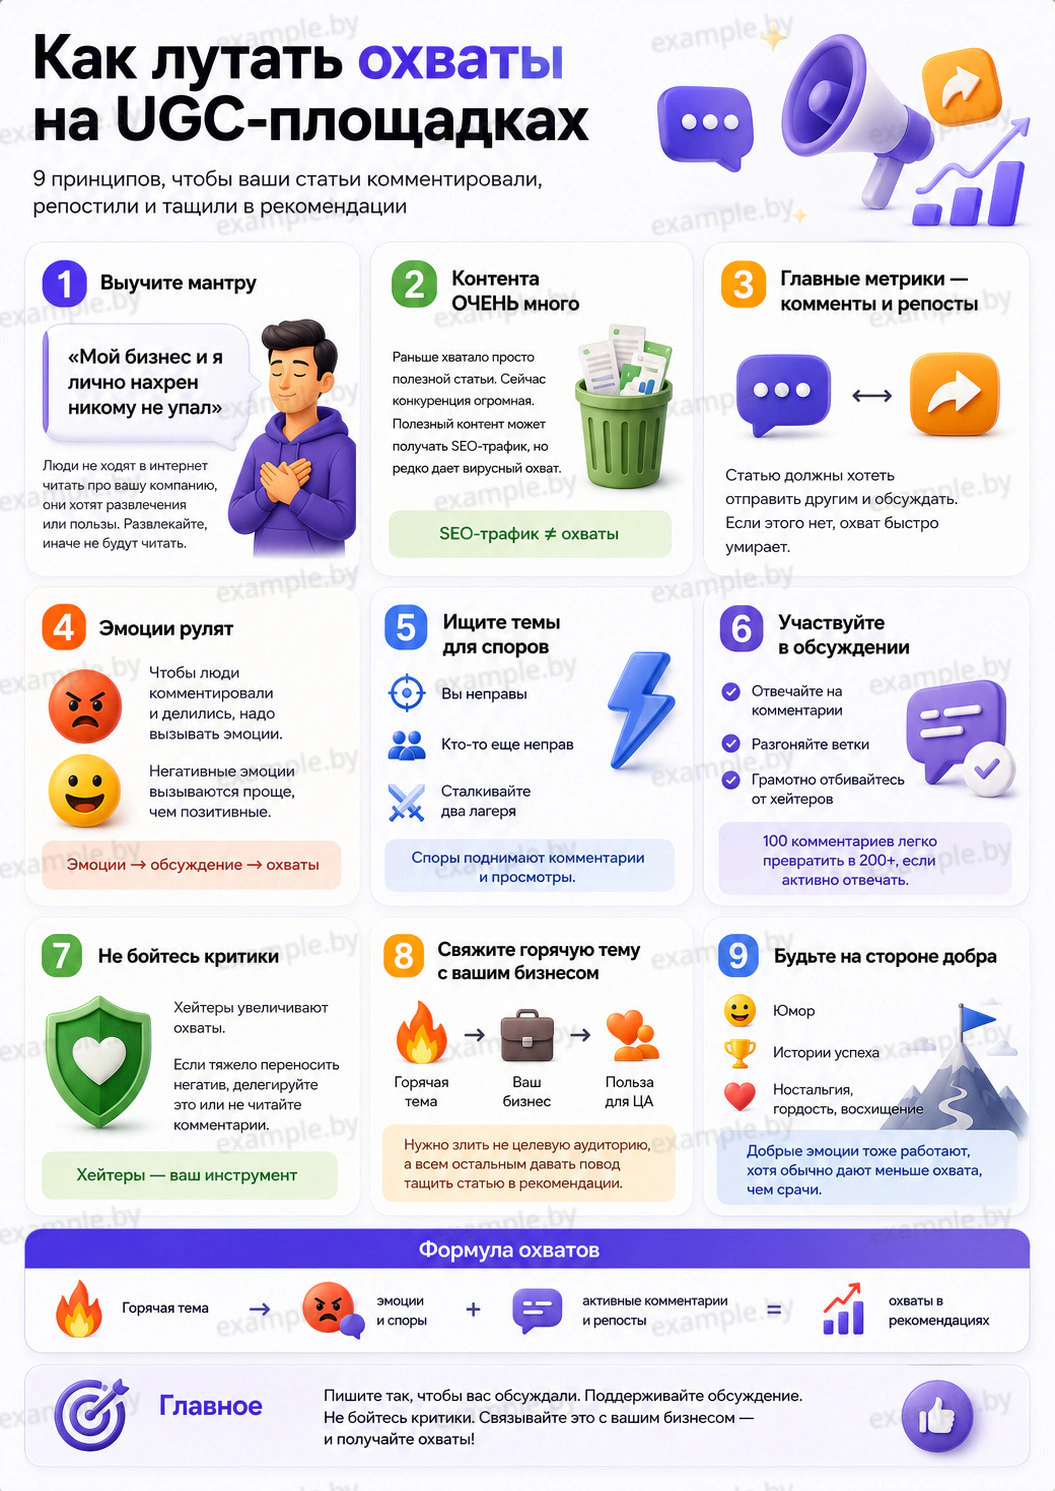
Как получать охваты на UGC-площадках
 Технологии · 07.10.26
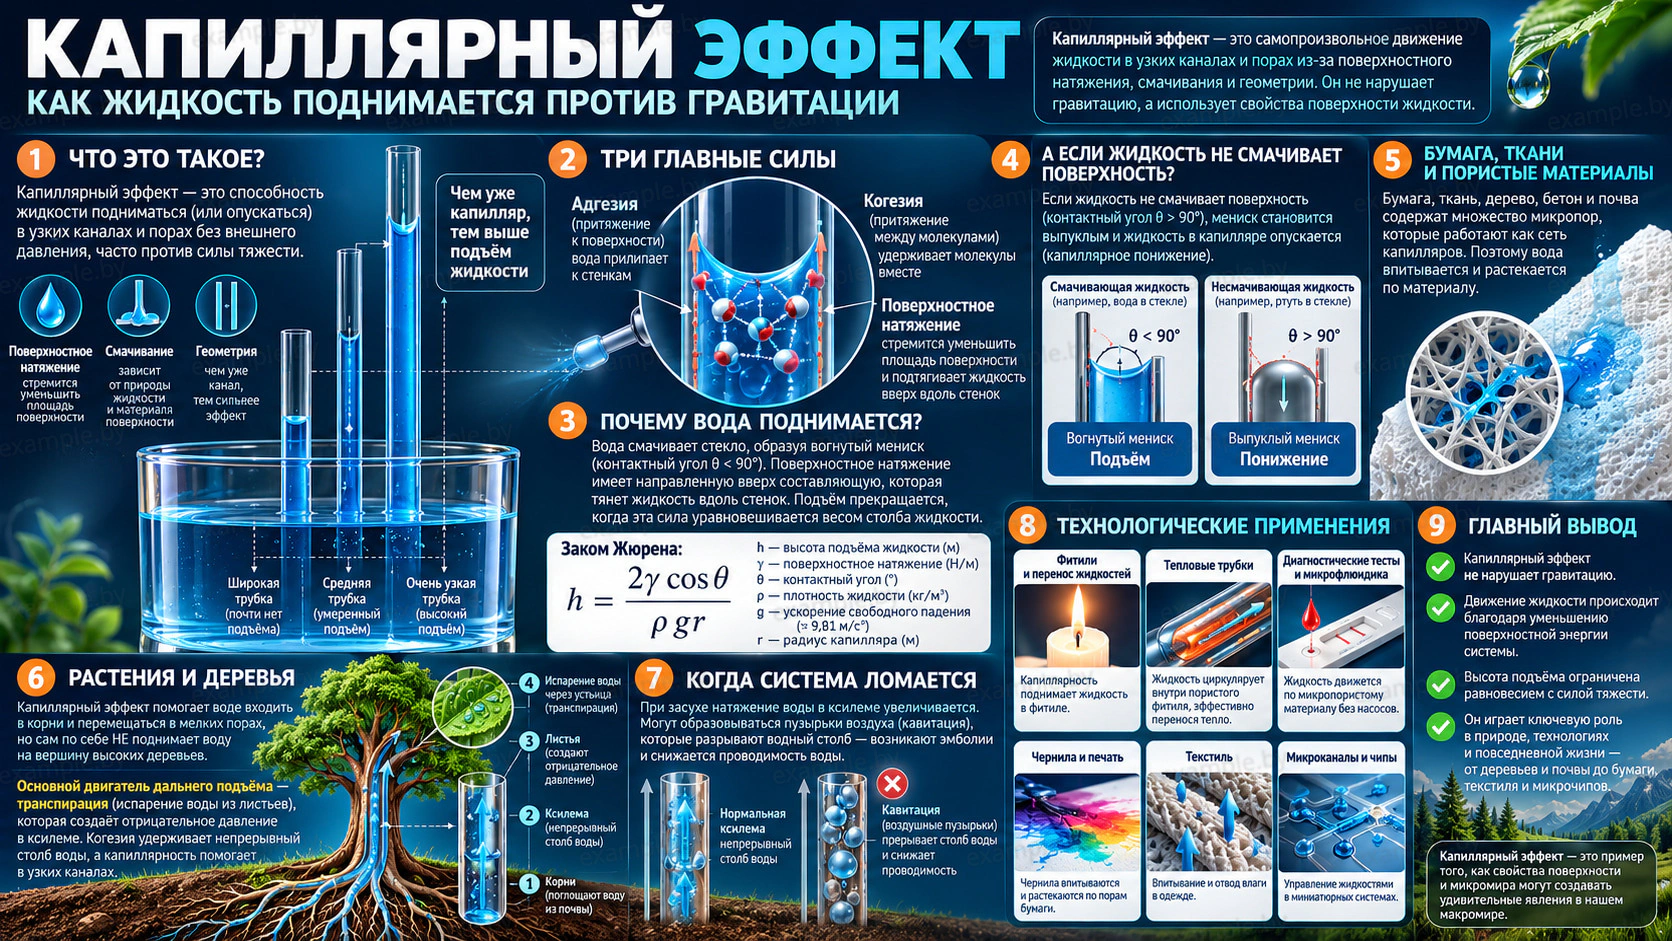
Капиллярный эффект: почему вода поднимается вверх
 Медицина · 05.10.26
Helicobacter pylori: как выжить в кислоте желудка
 Медицина · 03.10.26
Что на самом деле умеют ДНК-тесты
 Культура · 27.10.26
Почему у семьи могут быть разные фамилии
 Биология · 19.10.26
Почему кошки мурлычут и что значит этот звук
 Культура · 18.10.26
Как работает PR: механизмы, границы и доверие
 Еда · 18.10.26
Что на самом деле меняют пузырьки