Как машины ищут по смыслу: эмбеддинги и векторные БД
Разбираем устройство Chroma, pgvector и Qdrant: как работает приближённый поиск HNSW, зачем нужен Filterable HNSW и уступают ли локальные модели OpenAI.
- Рубрика
- Технологии
- Дата
- Чтение
- 25 минут
- Источник
- Qdrant, pgvector, Chroma
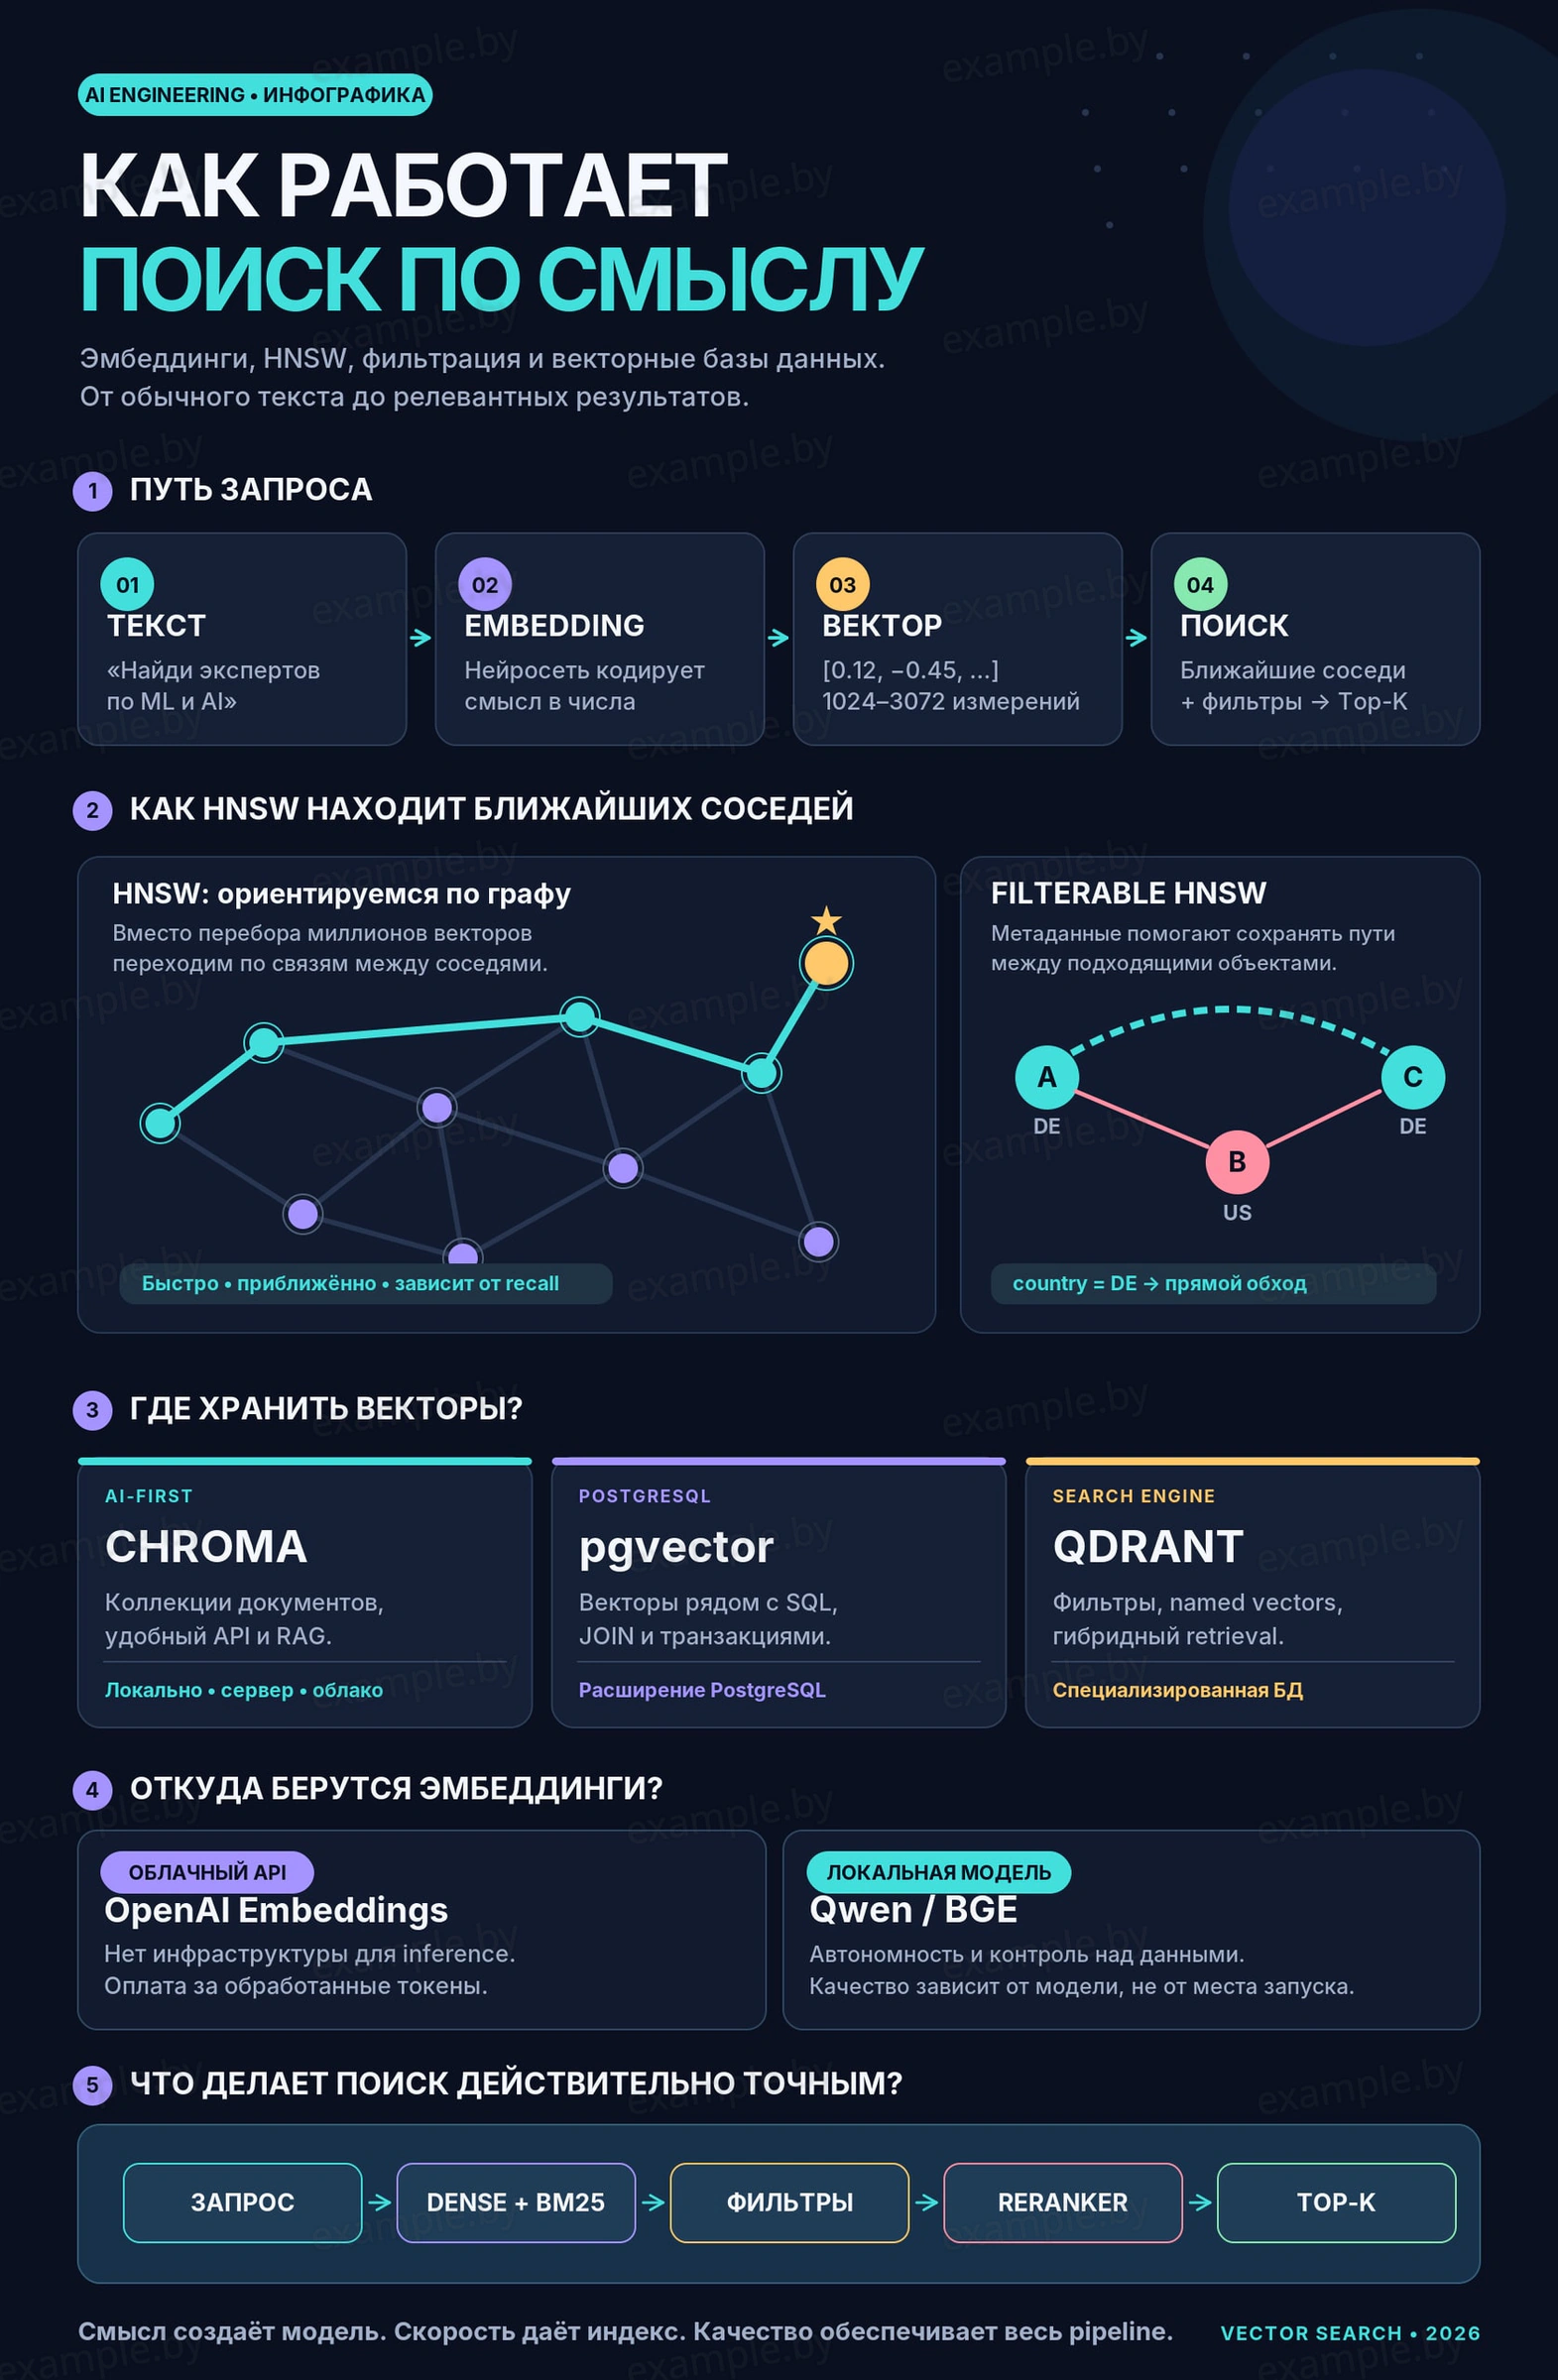
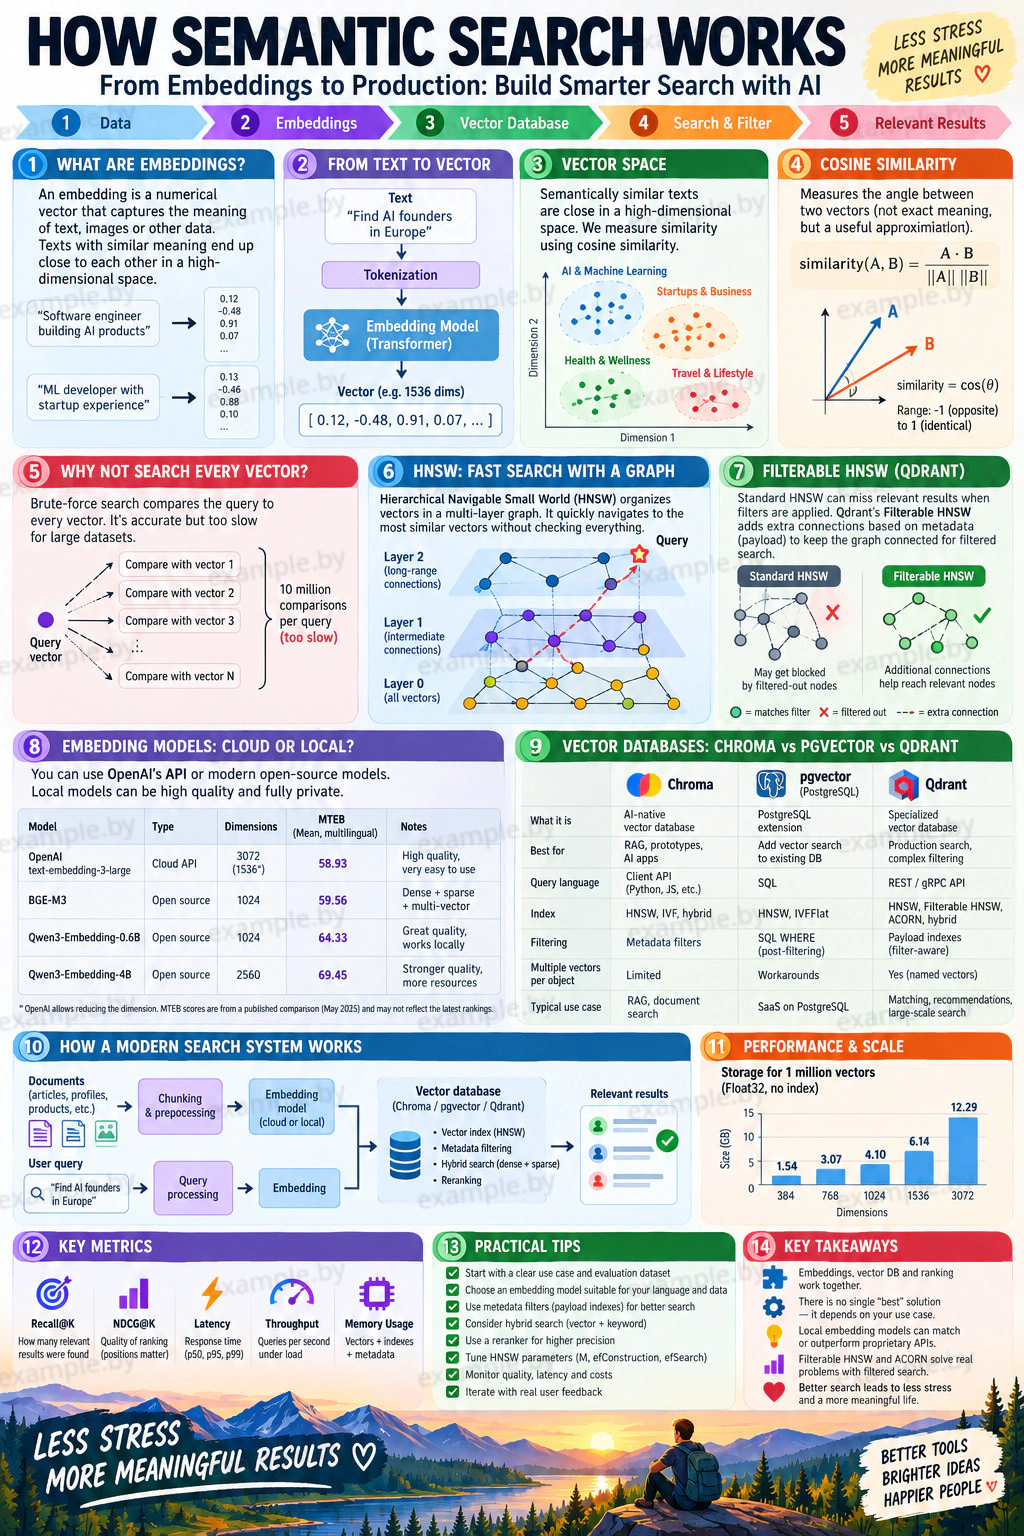
Представьте, что у вас есть миллион документов, пользовательских профилей или описаний товаров.
Пользователь вводит запрос:
«Найди специалистов, которые занимались разработкой AI-продуктов и запускали собственные стартапы».
При этом ни в одном из подходящих профилей может не оказаться именно такой формулировки.
Один человек написал «Co-founder of an ML startup». Другой указал «Built an LLM-powered SaaS from scratch». Третий описал опыт как «Machine Learning Engineer, early-stage ventures».
Традиционный поиск по ключевым словам может не заметить часть этих совпадений. А современный семантический поиск способен установить связь между текстами, даже когда они используют совершенно разные слова.
Как это возможно?
В основе технологии лежат три компонента:
Embedding-модель преобразует информацию в математические векторы.
Векторная база данных хранит эти представления и позволяет эффективно искать похожие.
Поисковый алгоритм находит ближайшие векторы, не сравнивая каждый запрос со всей базой.
Но самое интересное начинается, когда к семантической близости добавляются обычные бизнес-условия: страна, профессия, возраст документа, категория товара или доступ пользователя.
Здесь появляются HNSW, Filterable HNSW, ACORN и другие инженерные решения.
Разберём всю технологическую цепочку, от математических основ до production-архитектуры.
1. Что такое эмбеддинги и как машина представляет смысл числами
Компьютер не понимает слова так, как человек. Для алгоритмов поиска текст необходимо представить в виде чисел.
Embedding (эмбеддинг), это числовой вектор, который нейросетевая модель создаёт для некоторого объекта: текста, изображения, аудио или другого типа данных.
Для текстовой модели процесс выглядит примерно так:
        ИСХОДНЫЙ ТЕКСТ
               │
               ▼
       ┌──────────────┐
       │ Tokenization │
       └──────────────┘
               │
               ▼
       ┌─────────────────┐
       │ Embedding Model │
       │   Transformer   │
       └─────────────────┘
               │
               ▼
       ВЕКТОР ПРИЗНАКОВ

    [ 0.12, -0.48, 0.91,
      0.07,  0.33, ... ]

               │
               ▼
       ВЕКТОРНЫЙ ПОИСК
Например, модель может преобразовать предложение:
«Разработчик программного обеспечения с опытом создания AI-продуктов»
в вектор из 1024 чисел.
Другой текст:
«Software engineer building machine learning applications»
получит собственный вектор.
Если embedding-модель хорошо обучена на подобных задачах, эти векторы могут оказаться близкими в многомерном пространстве.
Почему близость векторов означает близость смысла?
В процессе обучения модель учится представлять определённые закономерности языка через числовые параметры.
Тексты, имеющие схожий смысл, часто получают похожие представления.
Но важно уточнить: эмбеддинг не является идеальной математической записью смысла.
Модель может ошибаться, путать контекст, неправильно обрабатывать отрицания или считать похожими документы, которые описывают противоположные действия.
Например:
- «Компания ищет инвесторов».
- «Компания не ищет инвесторов».
Для некоторых embedding-моделей эти предложения могут оказаться довольно близкими, поскольку большая часть содержания совпадает.
Поэтому семантическая близость, не то же самое, что логическая эквивалентность.
Как измеряется сходство?
Один из самых популярных методов, cosine similarity, косинусное сходство.
Математически:
Здесь:
- и , два вектора.
- , их скалярное произведение.
- и , длины векторов.
Косинусное сходство измеряет, насколько совпадают направления векторов.
Для ненулевых векторов значение находится в диапазоне от −1 до 1.
Чем ближе значение к 1, тем больше сходство направлений.
Важно, что это математическая мера близости, а не вероятность того, что документы одинаковы по смыслу.
Значение 0,85 не означает «85% совпадения смысла».
2. Сколько памяти занимают эмбеддинги?
Предположим, каждый текст представлен вектором из 1536 чисел.
Если каждое число хранится в формате Float32, оно занимает 4 байта.
Получается:
Это около 6 КБ на один вектор.
Для миллиона векторов потребуется примерно 6,14 ГБ только для хранения чисел.
Причём сюда ещё не входят метаданные, поисковые индексы и служебные структуры базы данных.
График 1. Размер векторного массива в зависимости от размерности
Из этого следует важный вывод.
Размерность эмбеддингов напрямую влияет на стоимость хранения и обработки данных.
Однако увеличение размерности не гарантирует повышения качества поиска.
Небольшая современная модель с 1024 измерениями может показывать лучшие результаты, чем более старая модель с 3072 измерениями.
Есть и другие способы экономить память: Float16, квантование векторов, уменьшение размерности с помощью моделей, поддерживающих Matryoshka Representation Learning (MRL).
Но каждый способ требует проверки влияния на качество поиска.
3. Почему нельзя просто сравнить все векторы?
Допустим, мы построили систему с 10 миллионами документов.
Пользователь отправляет запрос. Его текст преобразуется в embedding, после чего нужно найти 10 ближайших векторов.
Наивный алгоритм выглядит так:
              QUERY
                │
                ▼
       [0.12, 0.43, ...]
                │
                ▼
    ┌─────────────────────┐
    │ Сравнить с вектором 1│
    │ Сравнить с вектором 2│
    │ Сравнить с вектором 3│
    │         ...         │
    │ Сравнить с 10 000 000│
    └─────────────────────┘
                │
                ▼
          СОРТИРОВКА
                │
                ▼
            TOP-10
Такой подход называется exact nearest neighbor search, или точный поиск ближайших соседей.
Он обладает важным преимуществом: при корректном вычислении расстояний находит настоящие ближайшие векторы.
Но приходится вычислять расстояние до каждого кандидата.
Если в базе миллионы объектов, а одновременно приходят тысячи запросов, такой подход становится дорогим.
Для решения этой проблемы используют ANN, Approximate Nearest Neighbor Search.
То есть приближённый поиск ближайших соседей.
Его идея проста:
Вместо того чтобы проверять все объекты, попробуем быстро найти область пространства, где с высокой вероятностью находятся наиболее подходящие результаты.
Существуют разные подходы к ANN: графовые индексы, кластеризация, квантование и их комбинации.
Один из самых распространённых графовых алгоритмов, HNSW.
4. HNSW: как искать среди миллионов векторов, не перебирая их все
HNSW расшифровывается как Hierarchical Navigable Small World.
Это алгоритм, который организует векторы в многоуровневый граф.
Чтобы понять его идею, представим город.
Если мы ищем конкретный дом, не обязательно проверять каждый дом в стране.
Можно использовать иерархию:
          СТРАНА
             │
             ▼
           ГОРОД
             │
             ▼
           РАЙОН
             │
             ▼
           УЛИЦА
             │
             ▼
            ДОМ
У HNSW логика похожая, хотя его уровни не являются заранее заданными географическими или семантическими категориями.
Алгоритм строит связи между векторами, которые позволяют быстро перемещаться по пространству.
Как выглядит граф HNSW
Упрощённая схема:
УРОВЕНЬ 2, дальние переходы

        A ────────────── F
        │                │


УРОВЕНЬ 1, промежуточные связи

        A ───── C ────── F
        │       │        │
        B ───── D ────── G


УРОВЕНЬ 0, подробный граф

    A ─ B ─ C ─ D ─ E
    │   │   │   │   │
    F ─ G ─ H ─ I ─ J
    │   │   │   │   │
    K ─ L ─ M ─ N ─ O
Схема условная: настоящая структура графа нерегулярна, а связи определяются векторной близостью и процедурой построения индекса.
На верхних уровнях относительно мало узлов. Они позволяют совершать крупные переходы.
На нижнем уровне находятся все проиндексированные векторы и гораздо более подробные связи.
Поиск начинается с верхнего уровня и постепенно спускается вниз.
Как алгоритм выбирает путь?
Представим, что сейчас поиск находится в вершине A.
Алгоритм анализирует доступных соседей и ищет направление, приближающее его к запросу.
                       QUERY
                         ★
                         │
                D ────── E
               /         │
              C          F
             /           │
            B            G
           /
          A

      Начальная точка
В действительности поиск не ограничивается одной цепочкой: алгоритм поддерживает кандидатов и исследует несколько возможных переходов.
Важнейшее преимущество заключается в том, что ему обычно не нужно посещать все узлы.
Три важных параметра HNSW
M определяет количество связей между узлами графа.
Большое значение M потенциально повышает качество поиска, но увеличивает потребление памяти.
efConstruction управляет количеством кандидатов, рассматриваемых во время построения графа.
Повышение значения обычно делает построение индекса более дорогим, зато может улучшать качество связей.
efSearch управляет шириной поиска во время выполнения запроса.
Чем больше кандидатов рассматривает алгоритм, тем выше потенциальная полнота поиска, но тем больше вычислений требуется.
Здесь возникает классический инженерный компромисс:
Скорость ↔ качество поиска ↔ потребление памяти.
HNSW не гарантирует, что всегда найдёт математически ближайших соседей. Именно поэтому его результаты принято сравнивать с точным поиском. (github.com, qdrant.tech)
5. Filterable HNSW: что происходит, когда нужно учитывать фильтры?
В реальных приложениях редко достаточно просто найти десять ближайших векторов.
Обычно запрос содержит дополнительные условия.
Например:
Найти наиболее похожих специалистов, которые живут в Германии, имеют опыт работы с AI и доступны для новых проектов.
Получается:
SEMANTIC SEARCH

Похожесть профессионального опыта
                │
                +
                │
STRUCTURED FILTERS
                │
                ├── country = Germany
                ├── availability = true
                └── experience >= 5 years
                │
                ▼
             TOP-10
И здесь возникает проблема.
Почему обычный HNSW может плохо работать с фильтрами?
Представим базу из миллиона пользователей.
После применения всех условий остаётся только 5000 подходящих кандидатов, или 0,5% базы.
Есть три основных способа организовать поиск.
Первый способ: post-filtering.
Сначала находим 100 наиболее похожих векторов, а затем исключаем неподходящие.
Если подходящие пользователи распределены примерно равномерно, среди сотни результатов в среднем окажется всего 0,5 подходящего пользователя.
В итоге поиск может вернуть пустой список, хотя в базе существуют тысячи подходящих кандидатов.
Второй способ: pre-filtering.
Сначала отбираем 5000 подходящих пользователей, затем вычисляем расстояния до всех их векторов.
Это позволяет получить точный результат, если расстояния вычисляются для всех отобранных объектов.
Однако при сотнях тысяч подходящих кандидатов такой подход может оказаться дорогим.
Третий способ: filter-aware search.
А что, если сам алгоритм поиска будет учитывать ограничения во время перемещения по графу?
Именно эту задачу решает Filterable HNSW.
Как устроен Filterable HNSW в Qdrant
Обычный HNSW строит связи на основе векторной близости.
Но подходящие по фильтру вершины могут оказаться разделены неподходящими узлами.
Представим:
           ОБЫЧНЫЙ HNSW

      A (Germany, AI)
              │
              ▼
       B (France, AI)
              │
              ▼
      C (Germany, AI)


Фильтр: country = Germany
Узлы A и C проходят фильтр, а B, нет.
Если алгоритм ограничивает обход подходящими вершинами, он рискует потерять путь от A к C.
Qdrant решает проблему с помощью дополнительных связей.
          FILTERABLE HNSW

      A (Germany, AI)
        │           ╲
        │            ╲
        ▼             ╲
  B (France, AI)       ╲
        │               ╲
        ▼                ▼
      C (Germany, AI) ◄══╝


════ Дополнительная связь,
     полезная при фильтрации
Это условная иллюстрация: Qdrant не соединяет каждую пару объектов с одинаковыми метаданными.
Вместо этого при построении графа система добавляет связи, основанные на проиндексированных значениях payload.
То есть граф адаптируется не только к векторной близости, но и к будущим условиям поиска.
Для этого Qdrant использует два вида индексов:
- Vector index для поиска похожих векторов.
- Payload index для фильтрации по структурированным данным.
Payload-индексы также позволяют оценивать количество подходящих объектов и выбирать стратегию выполнения запроса.
Поэтому Qdrant может использовать как приближённый графовый поиск, так и точный перебор ограниченного набора кандидатов.
Важная особенность: payload-индексы рекомендуется создавать до загрузки данных. Если создать их после построения HNSW, для получения дополнительных связей потребуется перестроение графового индекса. (qdrant.tech)
А что такое ACORN?
Filterable HNSW не решает абсолютно все проблемы.
Допустим, система одновременно фильтрует по стране, профессии, возрасту документа и нескольким категориям.
Qdrant добавляет дополнительные связи для отдельных проиндексированных полей, но не для каждой возможной комбинации их значений.
В результате при нескольких строгих фильтрах граф всё ещё может терять полезные пути.
Для таких ситуаций Qdrant поддерживает ACORN, начиная с версии 1.16.
Основная идея ACORN состоит в расширении обхода графа.
Если ближайший сосед не подходит под фильтр, алгоритм может исследовать соседей этого соседа.
             QUERY
               │
               ▼
          A, подходит
               │
               ▼
          B, исключён
               │
               ▼
          C, подходит


    Обычный ограниченный обход
    может потерять полезный путь.

    ACORN исследует второй переход,
    даже когда B не проходит фильтр.
Это позволяет повышать полноту поиска в сложных сценариях, но требует дополнительных вычислений.
Таким образом, ACORN, не бесплатное ускорение. Это механизм улучшения качества поиска, особенно при сложных фильтрах. (qdrant.tech, qdrant.tech)
6. Chroma, pgvector и Qdrant: три подхода к одной задаче
Теперь мы понимаем, что такое эмбеддинги, векторный поиск и HNSW.
Но возникает практический вопрос: где хранить векторы и какую технологию выбрать?
Рассмотрим три популярных решения.
Chroma: AI-ориентированная база данных
Chroma, open-source система, ориентированная на хранение и поиск данных для AI-приложений.
Её основная абстракция, коллекция.
Коллекция содержит объекты, каждый из которых может иметь идентификатор, документ, embedding и метаданные.
Например:
import chromadb

client = chromadb.PersistentClient(path="./data")

collection = client.get_or_create_collection(
    name="articles"
)

collection.add(
    ids=["article-1", "article-2"],
    documents=[
        "Как работает векторный поиск",
        "Принципы построения нейросетей"
    ]
)

results = collection.query(
    query_texts=["Как искать похожие документы?"],
    n_results=2
)
В таком примере Chroma может использовать настроенную embedding-функцию для автоматического преобразования текста в векторы.
Это удобно: разработчику не обязательно сразу строить отдельную инфраструктуру для каждого этапа поиска.
Типичный сценарий:
     PDF / Markdown / HTML
               │
               ▼
          Text Chunks
               │
               ▼
        Embedding Model
               │
               ▼
          CHROMA DB
               │
               ▼
        Semantic Search
               │
               ▼
              LLM
               │
               ▼
             ANSWER
Важно, что современная Chroma уже не ограничивается локальными экспериментами.
Она поддерживает локальный embedded-режим, отдельный сервер и распределённое развёртывание. Доступны dense- и sparse-поиск, гибридный retrieval, полнотекстовый поиск и фильтрация метаданных.
Распределённая архитектура использует отдельные сервисы, объектное хранилище и SSD-кеширование. Поэтому называть Chroma исключительно инструментом для небольших прототипов было бы неправильно. (docs.trychroma.com, docs.trychroma.com)
Когда Chroma особенно интересна?
Когда требуется быстро разработать RAG-приложение, поиск по документам, исследовательский прототип или AI-ассистента.
При этом Python embedded-режим и JavaScript-клиент, не одно и то же: для обычного JS-клиента используется сервер Chroma или облачная база.
pgvector: векторный поиск внутри PostgreSQL
pgvector предлагает другой подход.
Вместо запуска отдельной специализированной базы данных можно добавить поддержку векторов непосредственно в PostgreSQL.
CREATE EXTENSION vector;

CREATE TABLE documents (
    id BIGSERIAL PRIMARY KEY,
    title TEXT,
    category TEXT,
    embedding VECTOR(1536)
);
Теперь PostgreSQL может выполнять векторные запросы:
SELECT id, title
FROM documents
WHERE category = 'technology'
ORDER BY embedding <=> $1::vector
LIMIT 10;
Оператор <=> вычисляет косинусное расстояние.
Для приближённого поиска можно создать HNSW-индекс:
CREATE INDEX documents_embedding_idx
ON documents
USING hnsw (embedding vector_cosine_ops);
Главное преимущество pgvector, интеграция с привычными возможностями PostgreSQL.
              APPLICATION
                   │
                   ▼
              PostgreSQL
                   │
         ┌─────────┼─────────┐
         │         │         │
         ▼         ▼         ▼
       Users    Payments   Documents
                             │
                             ▼
                         pgvector
                             │
                             ▼
                       Vector Search
Можно объединять векторную близость с SQL-фильтрами, JOIN, транзакциями и обычными индексами.
Это особенно удобно, когда AI-поиск является дополнительной функцией существующего приложения.
Однако есть важный нюанс.
В pgvector при использовании приближённого HNSW-индекса фильтрация обычным WHERE применяется после сканирования индекса.
Из-за этого строгие условия могут уменьшать количество найденных результатов.
Для улучшения ситуации доступны iterative scans, частичные HNSW-индексы, partitioning и другие оптимизации.
Например:
SET hnsw.iterative_scan = strict_order;
Такая настройка позволяет продолжать обход индекса, когда после фильтрации найдено недостаточно строк, в пределах установленных ограничений. (github.com)
Ещё одна техническая деталь: стандартный HNSW-индекс pgvector для типа vector поддерживает до 2000 измерений. Для больших размерностей можно использовать halfvec с индексированием до 4000 измерений или другие подходы.
Это существенно при использовании моделей, создающих векторы размерностью 3072 и выше. (github.com)
Qdrant: специализированный движок векторного поиска
Qdrant разработан вокруг задачи эффективного поиска по векторным представлениям.
Он особенно интересен для систем, в которых семантический поиск является одной из ключевых функций продукта.
Основные возможности включают HNSW, Filterable HNSW, payload-индексы, dense- и sparse-векторы, named vectors, гибридный поиск и комбинирование результатов нескольких поисковых этапов.
Например, один объект может иметь несколько смысловых представлений.
                PRODUCT
                   │
       ┌───────────┼───────────┐
       │           │           │
       ▼           ▼           ▼

   Description   Image       Reviews
     Vector      Vector       Vector

       │           │           │
       └───────────┼───────────┘
                   │
                   ▼
                 QDRANT
                   │
                   ▼
          Multi-stage Search
Это открывает возможности для сложных рекомендательных систем.
Например, интернет-магазин может искать товары одновременно по текстовому описанию, визуальному сходству и отзывам покупателей.
Qdrant позволяет хранить несколько named vectors у одного объекта и строить поисковые сценарии с разными представлениями данных.
Но значит ли это, что Qdrant всегда быстрее Chroma или pgvector?
Нет.
Реальная производительность зависит от конкретной нагрузки, структуры данных, размера индекса, селективности фильтров, параметров поиска и доступной памяти.
На небольшой базе PostgreSQL вполне может оказаться быстрее благодаря отсутствию сетевых переходов между отдельными сервисами.
А для большой специализированной поисковой системы Qdrant может оказаться удобнее благодаря механизмам индексирования, фильтрации и управления векторными данными.
Главное различие трёх решений
Их можно описать одной фразой:
Chroma предоставляет удобную AI-ориентированную инфраструктуру для retrieval.
pgvector добавляет векторный поиск в существующую реляционную базу данных.
Qdrant предлагает специализированную инфраструктуру для сложного векторного поиска и фильтрации.
Ни одно из решений не является универсальным победителем.
7. Можно ли создавать качественные эмбеддинги локально?
Следующий вопрос не менее интересен.
Предположим, мы выбрали Qdrant или Chroma.
Где получать сами эмбеддинги?
Обязательно ли использовать OpenAI API? Или обычный компьютер способен справиться с этой задачей?
Ответ: качественные эмбеддинги вполне можно вычислять локально.
Причём существуют открытые модели, которые на отдельных задачах превосходят коммерческие API.
Рассмотрим несколько примеров.
Qwen3-Embedding-0.6B
Компактная модель с 600 миллионами параметров.
Поддерживает более 100 языков, контекст до 32 тысяч токенов и эмбеддинги размерностью до 1024.
Её можно использовать на обычном компьютере, в том числе без дискретной видеокарты, хотя производительность будет зависеть от оборудования.
Qwen3-Embedding-4B
Более крупная модель с 4 миллиардами параметров.
Максимальная размерность эмбеддингов, 2560.
Она требует больше памяти и вычислительных ресурсов, но может обеспечивать лучшее качество поиска.
BGE-M3
Многоязычная embedding-модель, которая поддерживает несколько способов представления информации: dense, sparse и multi-vector.
Это делает её интересной для гибридного поиска, где требуется учитывать и семантическую близость, и конкретные слова.
Как сравнить качество моделей?
Для этого существует MTEB (Massive Text Embedding Benchmark).
Он оценивает модели на различных задачах, включая retrieval, классификацию, кластеризацию и семантическую близость.
Посмотрим на результаты одного сравнительного среза, опубликованного авторами Qwen.
График 2. Качество embedding-моделей на Multilingual MTEB
В этом сравнении даже Qwen3-Embedding-0.6B превосходит OpenAI text-embedding-3-large по среднему показателю.
Однако здесь необходимо сделать несколько оговорок.
Во-первых, это результаты конкретного набора тестов, а не универсальная оценка качества.
Во-вторых, сравнение опубликовано авторами семейства Qwen, поэтому его желательно дополнять независимыми измерениями.
В-третьих, разные задачи требуют разных свойств от эмбеддингов.
Модель, которая хорошо находит похожие предложения, не обязательно будет лучшей для поиска товаров по артикулу или подбора специалистов по строгим профессиональным требованиям.
Тем не менее результаты демонстрируют важный факт: локальные open-source модели уже способны конкурировать с мощными облачными решениями. (huggingface.co)
8. Почему тогда многие продолжают использовать OpenAI Embeddings?
Потому что качество, только один из критериев.
Облачный API избавляет разработчиков от необходимости самостоятельно запускать и обслуживать модель.
Не нужно разбираться с GPU, квантованием, inference-серверами, пакетной обработкой и распределением вычислительных ресурсов.
Кроме того, создание эмбеддингов через API может стоить удивительно мало.
На момент подготовки материала OpenAI указывает следующие стандартные цены:
text-embedding-3-small: $0.02 за миллион входных токенов.text-embedding-3-large: $0.13 за миллион входных токенов.
Источник: OpenAI API. (developers.openai.com)
Пример стоимости
Представим, что нужно создать эмбеддинги для 10 000 документов.
Каждый документ содержит в среднем 500 токенов.
Общий объём:
Получается примерно:
$0.10 при использовании text-embedding-3-small.
$0.65 при использовании text-embedding-3-large.
И это стоимость первоначальной генерации эмбеддингов, а не ежемесячная плата за хранение.
Разумеется, при обработке поисковых запросов и обновлении документов также будут расходоваться токены.
Но для многих небольших проектов расходы на API настолько малы, что запуск локального inference-сервера не даёт заметной экономической выгоды.
Когда локальные модели становятся особенно привлекательными?
Когда важны автономность, контроль над данными, отсутствие зависимости от внешнего API или обработка больших потоков информации на уже имеющемся оборудовании.
Например:
           PRIVATE DOCUMENTS
                   │
                   ▼
          LOCAL EMBEDDING MODEL
                   │
                   ▼
           LOCAL VECTOR DB
                   │
                   ▼
              LOCAL SEARCH
При полностью локальной обработке исходные документы не нужно передавать стороннему API.
Это полезно для персональных AI-ассистентов, корпоративных документов и offline-приложений.
При этом локальный запуск не должен автоматически ухудшать качество эмбеддингов.
Если используются одинаковые веса модели, токенизатор, precision и параметры обработки, результаты локального и серверного inference должны быть практически одинаковыми.
Различия могут возникать из-за квантования, особенностей вычислений и неправильной настройки модели.
Для некоторых моделей важно даже то, используется ли специальная инструкция для поискового запроса.
Например, авторы Qwen3 рекомендуют задавать инструкции, описывающие retrieval-задачу, поскольку это может улучшать результат. (huggingface.co)
9. Как выглядит современная архитектура семантического поиска
Теперь объединим все компоненты.
Предположим, мы разрабатываем поисковую систему для базы технических статей.
Пользователь может искать материалы естественным языком.
Система должна учитывать категорию, язык и дату публикации.
При этом результаты должны быть не просто семантически близкими, а действительно отвечающими на вопрос.
Одна из возможных архитектур выглядит так:
                 DATA PIPELINE
                      │
                      ▼
            ┌─────────────────┐
            │ Documents       │
            │ Articles        │
            │ Knowledge Base  │
            └─────────────────┘
                      │
                      ▼
               Text Chunking
                      │
                      ▼
              Embedding Model
                      │
                      ▼
              Vector Database
                      │
                      ▼
               Vector Index


═════════════════════════════════════════


                  USER QUERY
                      │
                      ▼
              Query Processing
                      │
           ┌──────────┴──────────┐
           │                     │
           ▼                     ▼
     Embedding Model       Keyword Search
           │                     │
           ▼                     ▼
      Dense Search          Sparse / BM25
           │                     │
           └──────────┬──────────┘
                      │
                      ▼
              Result Fusion
                      │
                      ▼
              Metadata Filters
                      │
                      ▼
              Candidate Set
                      │
                      ▼
                 Reranker
                      │
                      ▼
                  FINAL TOP-K
                      │
                      ▼
                LLM / USER
Это логическая схема, а не обязательный порядок выполнения операций. В реальной системе метаданные могут фильтроваться непосредственно во время retrieval, в том числе через Filterable HNSW.
Здесь появляются два важных компонента, которые мы ещё не обсуждали подробно.
Hybrid Search: зачем объединять векторный и обычный поиск?
Семантический поиск хорошо находит смысловые соответствия.
Но иногда точное совпадение слов оказывается важнее.
Например:
«Ошибка PostgreSQL 23505».
В данном случае число 23505 является конкретным кодом ошибки.
Embedding-модель может найти статьи об ограничениях уникальности PostgreSQL, но буквальный поиск по коду может дать более надёжный результат.
Поэтому современные системы часто объединяют:
Dense Search, семантический поиск по эмбеддингам.
Sparse Search / BM25, поиск, учитывающий конкретные термины и их значимость.
Затем результаты объединяются.
Один из распространённых методов, Reciprocal Rank Fusion (RRF).
Он комбинирует несколько ранжированных списков с учётом позиций документов.
Такой подход полезен, когда пользовательский запрос одновременно содержит естественный язык и важные ключевые слова.
Reranking: почему ближайший вектор не всегда лучший ответ?
Предположим, векторная база нашла 100 кандидатов.
Все они семантически близки к запросу.
Но некоторые лучше отвечают на вопрос, чем другие.
Для более точной оценки можно использовать reranker.
Схема:
           USER QUERY
                │
                ▼
          VECTOR SEARCH
                │
                ▼
         100 CANDIDATES
                │
                ▼
             RERANKER
                │
                ▼
           BEST 10 RESULTS
Embedding-модель обычно преобразует запрос и документы в независимые векторы.
Reranker может анализировать сам запрос вместе с текстом конкретного документа и выдавать оценку релевантности пары.
За счёт этого он способен учитывать детали, которые не были очевидны из первоначального векторного сходства.
Но есть компромисс: reranking дополнительных кандидатов увеличивает время обработки запроса.
Поэтому распространённая стратегия, быстро получить ограниченный набор кандидатов, а затем применить к ним более дорогую модель.
10. Как правильно оценивать качество векторного поиска
Одна из распространённых ошибок, выбирать векторную базу исключительно по скорости.
Например, система A выполняет запрос за 8 мс, а система B за 20 мс.
Можно ли утверждать, что A лучше?
Нет, пока мы не знаем, насколько релевантны найденные результаты.
Для оценки используются несколько важных метрик.
Recall@K
Показывает, какую долю подходящих результатов удалось найти.
Однако здесь есть два разных способа применения.
ANN Recall@K сравнивает приближённый поиск с точным поиском по тем же векторам.
Он позволяет измерить качество работы индекса.
Например, точный поиск нашёл десять ближайших векторов, а ANN вернул восемь из них.
Тогда Recall@10 относительно точного поиска составляет 80%.
Но этот показатель ничего не говорит о том, насколько сами векторы правильно отражают смысл.
Retrieval Recall@K сравнивает найденные результаты с заранее известными релевантными документами.
Он помогает оценивать уже качество поисковой системы с точки зрения задачи пользователя.
Это принципиально разные измерения.
NDCG@K
Normalized Discounted Cumulative Gain учитывает не только наличие релевантных документов, но и их позиции.
Если самый полезный документ находится на первом месте, это лучше, чем если он появляется только на десятой позиции.
Поэтому NDCG особенно интересна для рекомендательных систем и поисковых интерфейсов.
Latency
Время выполнения запроса.
Но одного среднего значения недостаточно.
Стоит смотреть на p50, p95 и p99.
Например, если большинство запросов выполняется быстро, но каждый двадцатый занимает несколько секунд, пользовательский опыт может существенно ухудшиться.
Throughput
Количество запросов, которое система способна обрабатывать за единицу времени.
Особенно важно измерять его при реальной параллельной нагрузке.
Memory Usage
Нужно учитывать не только размер самих векторов, но и память, занимаемую индексами, метаданными и кешем.
Главная идея оценки
Качество полноценной поисковой системы зависит как минимум от двух независимых компонентов:
Это не формула для численного расчёта, а способ показать зависимость.
Даже идеальный векторный индекс не исправит плохие эмбеддинги.
И наоборот: великолепная embedding-модель не гарантирует качественных результатов, если поисковый алгоритм теряет подходящих кандидатов.
11. Как выбрать технологический стек
После всех сравнений можно сформулировать несколько практических принципов.
Если разрабатывается RAG или AI-ассистент
Хорошим начальным вариантом может стать Chroma.
Особенно если необходимо быстро организовать поиск по документам и экспериментировать с моделями.
Но по мере развития проекта стоит отдельно проверить требования к масштабированию, языковой поддержке, фильтрации и инфраструктуре.
Если приложение уже использует PostgreSQL
Начать стоит с pgvector.
Он позволит добавить векторный поиск без внедрения отдельной базы данных.
Для умеренных объёмов данных и относительно простых поисковых сценариев это может оказаться наиболее рациональным решением.
Если векторный поиск является ключевой функцией продукта
Стоит внимательно рассмотреть Qdrant.
Особенно если требуется поиск по нескольким представлениям одного объекта, сложная фильтрация, гибридный retrieval и масштабируемая специализированная инфраструктура.
Если нужны полностью локальные AI-функции
Можно использовать открытую embedding-модель и локальную векторную базу.
Но важно учитывать, что размер модели, занимаемая память и скорость генерации эмбеддингов будут напрямую зависеть от доступного оборудования.
Если требуется максимально простая эксплуатация
Облачный embedding API в сочетании с существующей базой данных часто оказывается экономически привлекательным.
Особенно на ранних этапах продукта.
12. Пять распространённых заблуждений о векторном поиске
«Чем больше размерность эмбеддингов, тем качественнее поиск».
Необязательно. Качество зависит от архитектуры и обучения модели, а не только от количества чисел в выходном векторе.
«HNSW всегда возвращает ближайшие объекты».
Нет. Это алгоритм приближённого поиска. Его преимущество заключается в хорошем компромиссе между скоростью и полнотой результатов.
«Векторная база данных сама понимает смысл текста».
Обычно смысловое представление создаёт embedding-модель. База данных отвечает за хранение, индексацию, фильтрацию и поиск по этим представлениям. Некоторые системы могут дополнительно интегрировать генерацию эмбеддингов.
«Для сложного поиска достаточно обычного cosine similarity».
Не всегда. При наличии строгих бизнес-условий, точных терминов и требований к ранжированию могут понадобиться payload-фильтры, гибридный поиск и reranking.
«Облачные эмбеддинги заведомо лучше локальных».
Это уже не универсальное правило. Качество зависит от конкретной модели и задачи, а современные open-source решения показывают конкурентоспособные результаты.
Есть и ещё одна архитектурная ловушка: нельзя просто заменить embedding-модель и продолжить поиск по старым векторам, даже если размерность совпадает.
Разные модели создают разные векторные пространства. При миграции необходимо пересчитать сохранённые эмбеддинги либо поддерживать отдельные представления данных для разных моделей.
Заключение. Поиск по смыслу, это не одна технология, а целая система
За простым пользовательским запросом скрывается несколько самостоятельных инженерных задач.
Нужно преобразовать текст в числовое представление.
Организовать эффективное хранение миллионов векторов.
Научиться находить ближайших соседей без полного перебора базы.
Учитывать структурированные фильтры.
Объединять семантический и лексический поиск.
И наконец, оценивать не только скорость ответа, но и качество найденных результатов.
Если собрать всё вместе, получится следующая архитектура:
                 AI SEARCH SYSTEM

                       │
                       ▼
              EMBEDDING MODEL
             ┌─────────┴─────────┐
             │                   │
             ▼                   ▼
       OpenAI API            Local Model
                             Qwen / BGE
             │                   │
             └─────────┬─────────┘
                       │
                       ▼
                 VECTOR SPACE
                       │
                       ▼
                VECTOR DATABASE
             ┌─────────┼─────────┐
             │         │         │
             ▼         ▼         ▼
           Chroma   pgvector   Qdrant
             │         │         │
             └─────────┼─────────┘
                       │
                       ▼
                  ANN SEARCH
                    HNSW
                       │
                       ▼
                FILTERED SEARCH
                       │
                       ▼
                 HYBRID SEARCH
                       │
                       ▼
                    RERANKER
                       │
                       ▼
               RELEVANT RESULTS
Chroma, pgvector и Qdrant, это не три поколения одной технологии и не три варианта с заведомо разным уровнем качества.
Это разные архитектурные подходы к построению поисковых систем.
HNSW решает проблему эффективного поиска в многомерном пространстве. Filterable HNSW и ACORN помогают сочетать векторную близость со структурированными ограничениями. А современные embedding-модели, включая локальные open-source решения, определяют, насколько хорошо сама информация представлена в этом пространстве.
Именно взаимодействие этих компонентов определяет конечное качество AI-поиска.
Возможно, самый интересный вывод заключается в том, что развитие векторного поиска постепенно смещает внимание разработчиков от вопроса «как быстро найти ближайшие числа?» к гораздо более сложному:
Как построить систему, которая находит не просто математически похожие объекты, а действительно полезную информацию?
И ответ на него всё чаще лежит не в выборе одной идеальной базы данных, а в грамотном сочетании моделей, индексов, фильтров и алгоритмов ранжирования.
Основные технические источники
Для дальнейшего изучения и проверки деталей:
- Chroma Documentation, архитектура Chroma, коллекции, локальный и распределённый режимы.
- pgvector GitHub, реализация HNSW, SQL-запросы, индексы и ограничения.
- Qdrant: Indexing, payload indexes и Filterable HNSW.
- Qdrant: Search, параметры поиска и ACORN.
- Qwen3-Embedding, описание моделей, результаты MTEB и примеры inference.
- MTEB Leaderboard, сравнение embedding-моделей.
- OpenAI Embeddings, модели, API и работа с векторными представлениями.
Материал подготовлен с учётом доступной документации на октябрь 2026 года [проверить: дата в будущем]. Приведённые показатели MTEB относятся к опубликованному сравнительному срезу 2025 года. График размеров векторов основан на математическом расчёте; схемы архитектуры и алгоритмов упрощены для наглядности.
Понравилось? Сохрани, чтобы вернуться.
 Технологии · 16.10.26
Жизненный цикл звезды: от туманности до чёрной дыры
 Технологии · 15.10.26
Как устроен векторный поиск: Chroma, pgvector и Qdrant
 Технологии · 13.10.26
Как умные весы считают мышцы и воду: физика биоимпеданса
 Технологии · 13.10.26
Как получать охваты на UGC-площадках
 Технологии · 07.10.26
Капиллярный эффект: почему вода поднимается вверх
 Технологии · 04.10.26
Бенчмарки ИИ: как тестируют модели и почему врут рейтинги
 Медицина · 05.10.26
Helicobacter pylori: как выжить в кислоте желудка
 Медицина · 03.10.26
Что на самом деле умеют ДНК-тесты
 Культура · 27.10.26
Почему у семьи могут быть разные фамилии
 Биология · 19.10.26
Почему кошки мурлычут и что значит этот звук
 Культура · 18.10.26
Как работает PR: механизмы, границы и доверие
 Еда · 18.10.26
Что на самом деле меняют пузырьки